Genomic Pipeline Orchestrator — Orchestrazione dati per l’analisi genomica
Una piattaforma per semplificare l’esecuzione di workflow genomici complessi da dati grezzi a risultati, con interfaccia accessibile anche a biologi e ricercatori non sviluppatori.
L’analisi di dati genomici richiede strumenti molto potenti, ma spesso difficili da usare per chi non è programmatore. Questo progetto rende i workflow di analisi accessibili, ripetibili e automatizzati, creando un ponte tra i dati grezzi e i cluster HPC senza riga di comando visibile.
RUOLO
System Architect, Developer & Integrator
STACK
Vue 3, Cloud Functions (JS), Firebase
CORE
Hybrid Pipeline Orchestration
STATUS
R&D Pilot
La Sfida
Rendere accessibili i workflow genomici
L’analisi genetica moderna si basa su algoritmi estremamente complessi che richiedono l’esecuzione su infrastrutture ad alte prestazioni (HPC) e spesso vengono eseguiti da linee di comando specialistiche. Questo crea una barriera: i ricercatori e i biologi devono imparare o dipendere da sviluppatori per lanciare anche operazioni standard su grandi dataset.
La sfida qui non era riscrivere gli algoritmi di sequenziamento, ma semplificare l’interazione con essi: permettere a chi lavora con dati genomici di caricare i propri file (FASTQ/VCF) e avviare pipeline di elaborazione su cluster HPC senza scrivere codice, riducendo il tempo speso in operazioni di routine e aumentando l’efficienza del team.
L'Architettura
Architettura ibrida per workflow genomici
Dietro questa piattaforma c’è una WebApp moderna (Vue3 + Vuetify) che si occupa di logica, permessi e orchestrazione. Il cuore dell’esecuzione dei workflow è distribuito tra cloud e calcolo locale, integrando strumenti specialistici senza richiedere competenze di programmazione all’utente finale.
Markup tecnico sintetico da incollare:
La WebApp gestisce autenticazione, permessi e interfaccia utente
Il backend serverless su Google Cloud Functions gestisce la logica di orchestrazione.
Il collegamento con l’hardware locale (HPC) avviene tramite un trigger Python che osserva il NAS sincronizzato via Drive e avvia automaticamente pipeline di analisi.
Perché questo progetto porta vantaggi reali
Questa piattaforma non è solo un’infrastruttura tecnica: è pensata per aumentare produttività, ripetibilità e autonomia operativa nei team che processano grandi dataset genomici.
Accessibilità semplificata
Permette ai ricercatori di avviare workflow senza competenze di programmazione o uso di shell.
Automazione delle pipeline
I processi di analisi si avviano automaticamente al caricamento dei dati, riducendo gli errori manuali
Ripetibilità garantita
Ogni pipeline è eseguita con configurazioni tracciabili e uniformi, migliorando la qualità dei risultati
Integrazione con infrastrutture esistenti
Funziona con cluster HPC esistenti, sfruttando NAS e trigger locali per lanciare analisi complesse
Uso ibrido cloud/on-premise
Il sistema gestisce orchestrazione serverless e computazione locale, combinando facilità d’uso e potenza di calcolo.
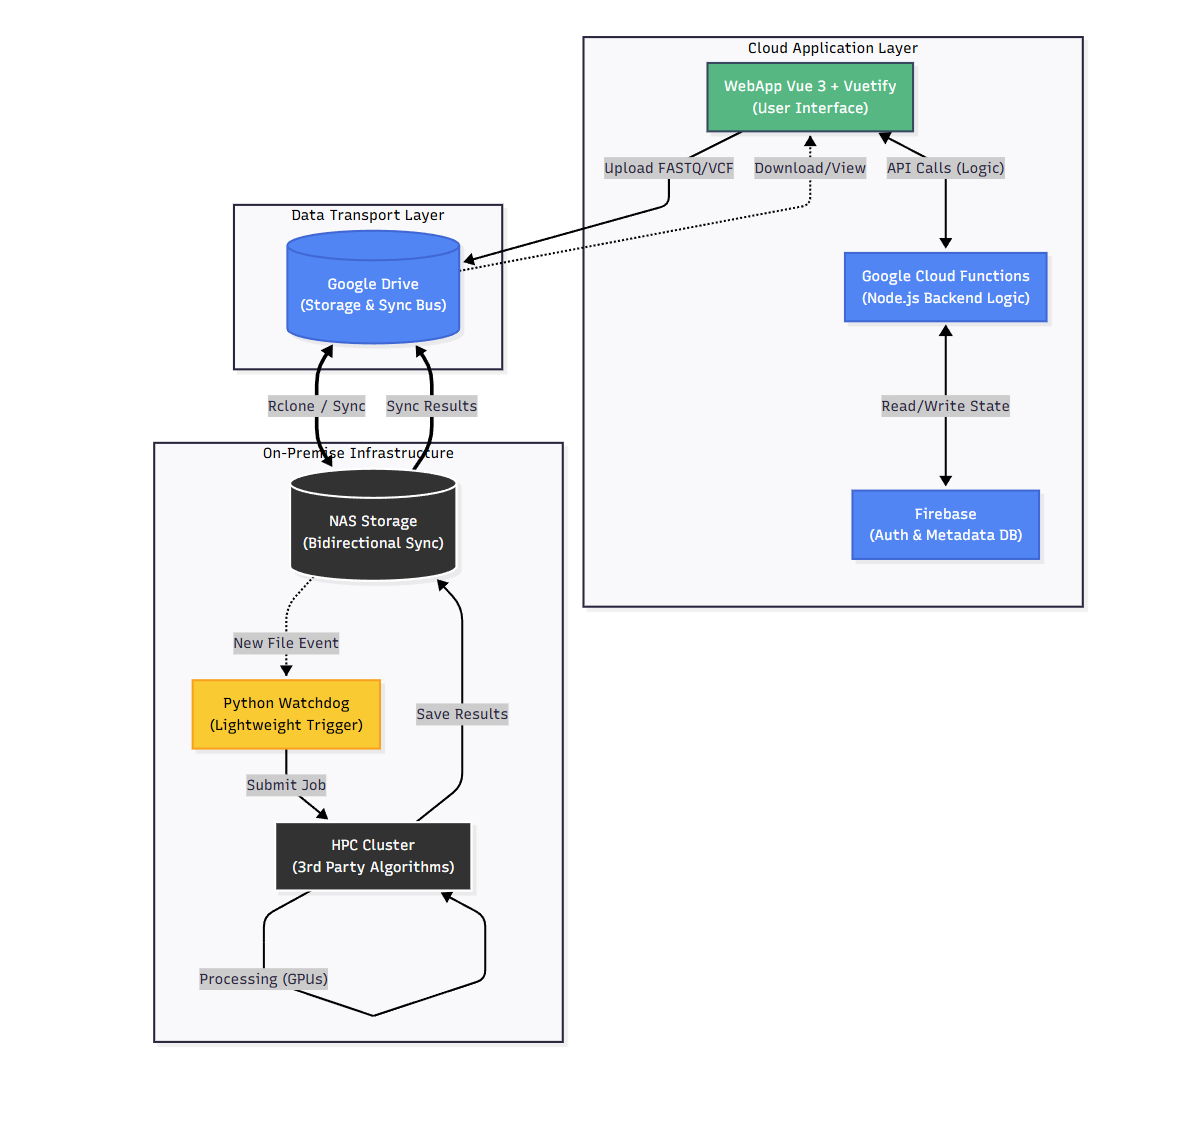
Fig 1. Architettura "Privacy-First": Inferenza AI locale via WebAssembly senza trasmissione video al cloud.
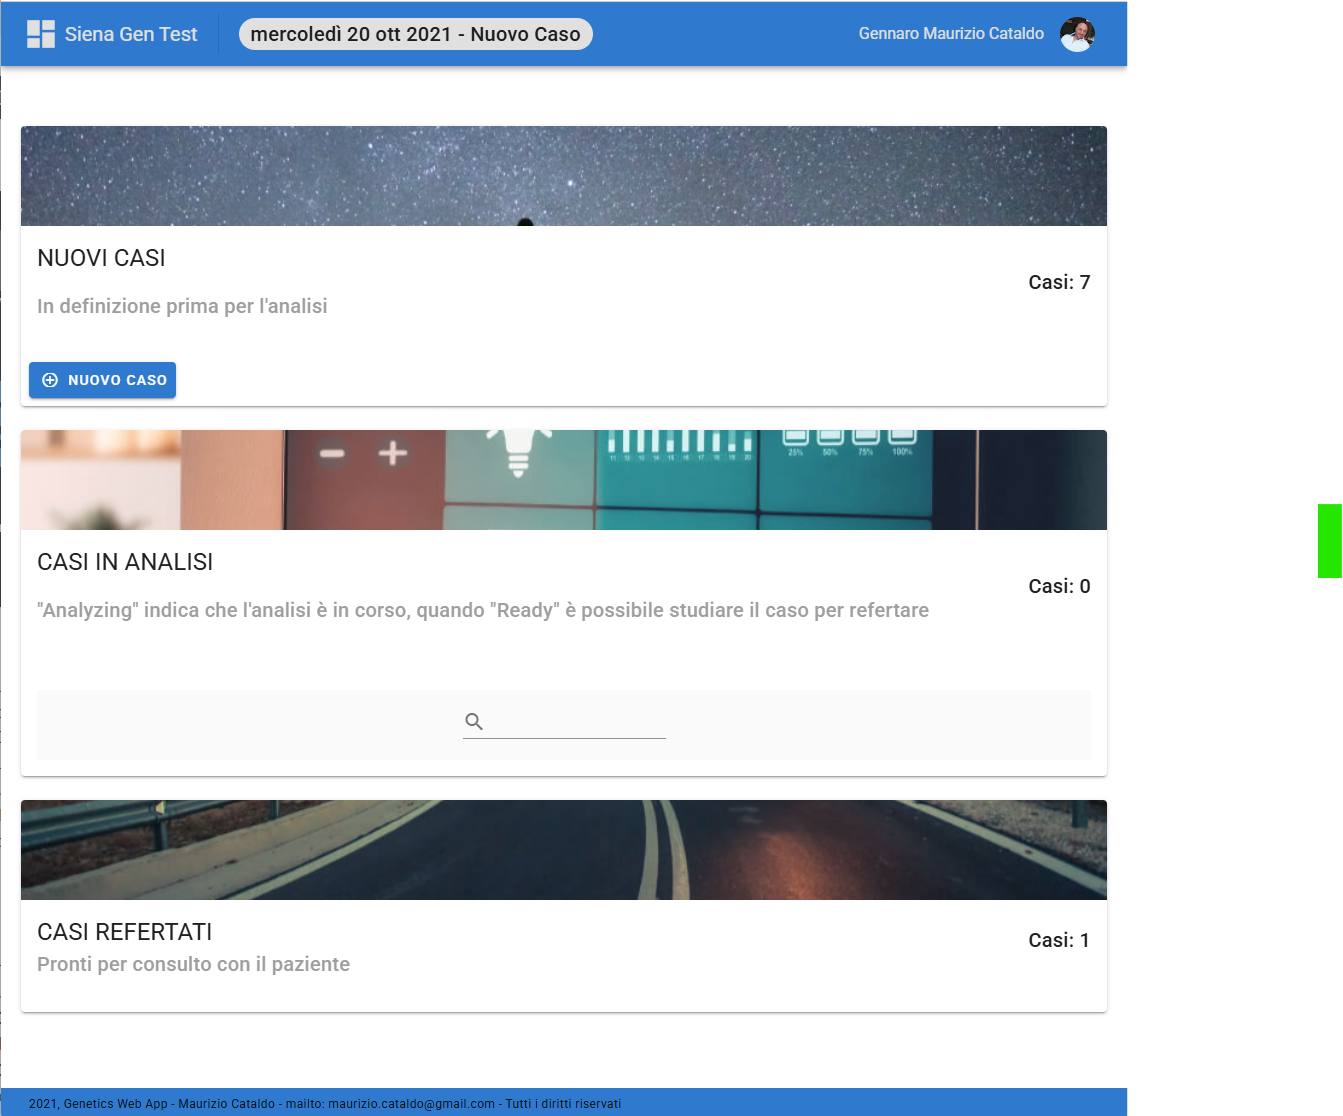
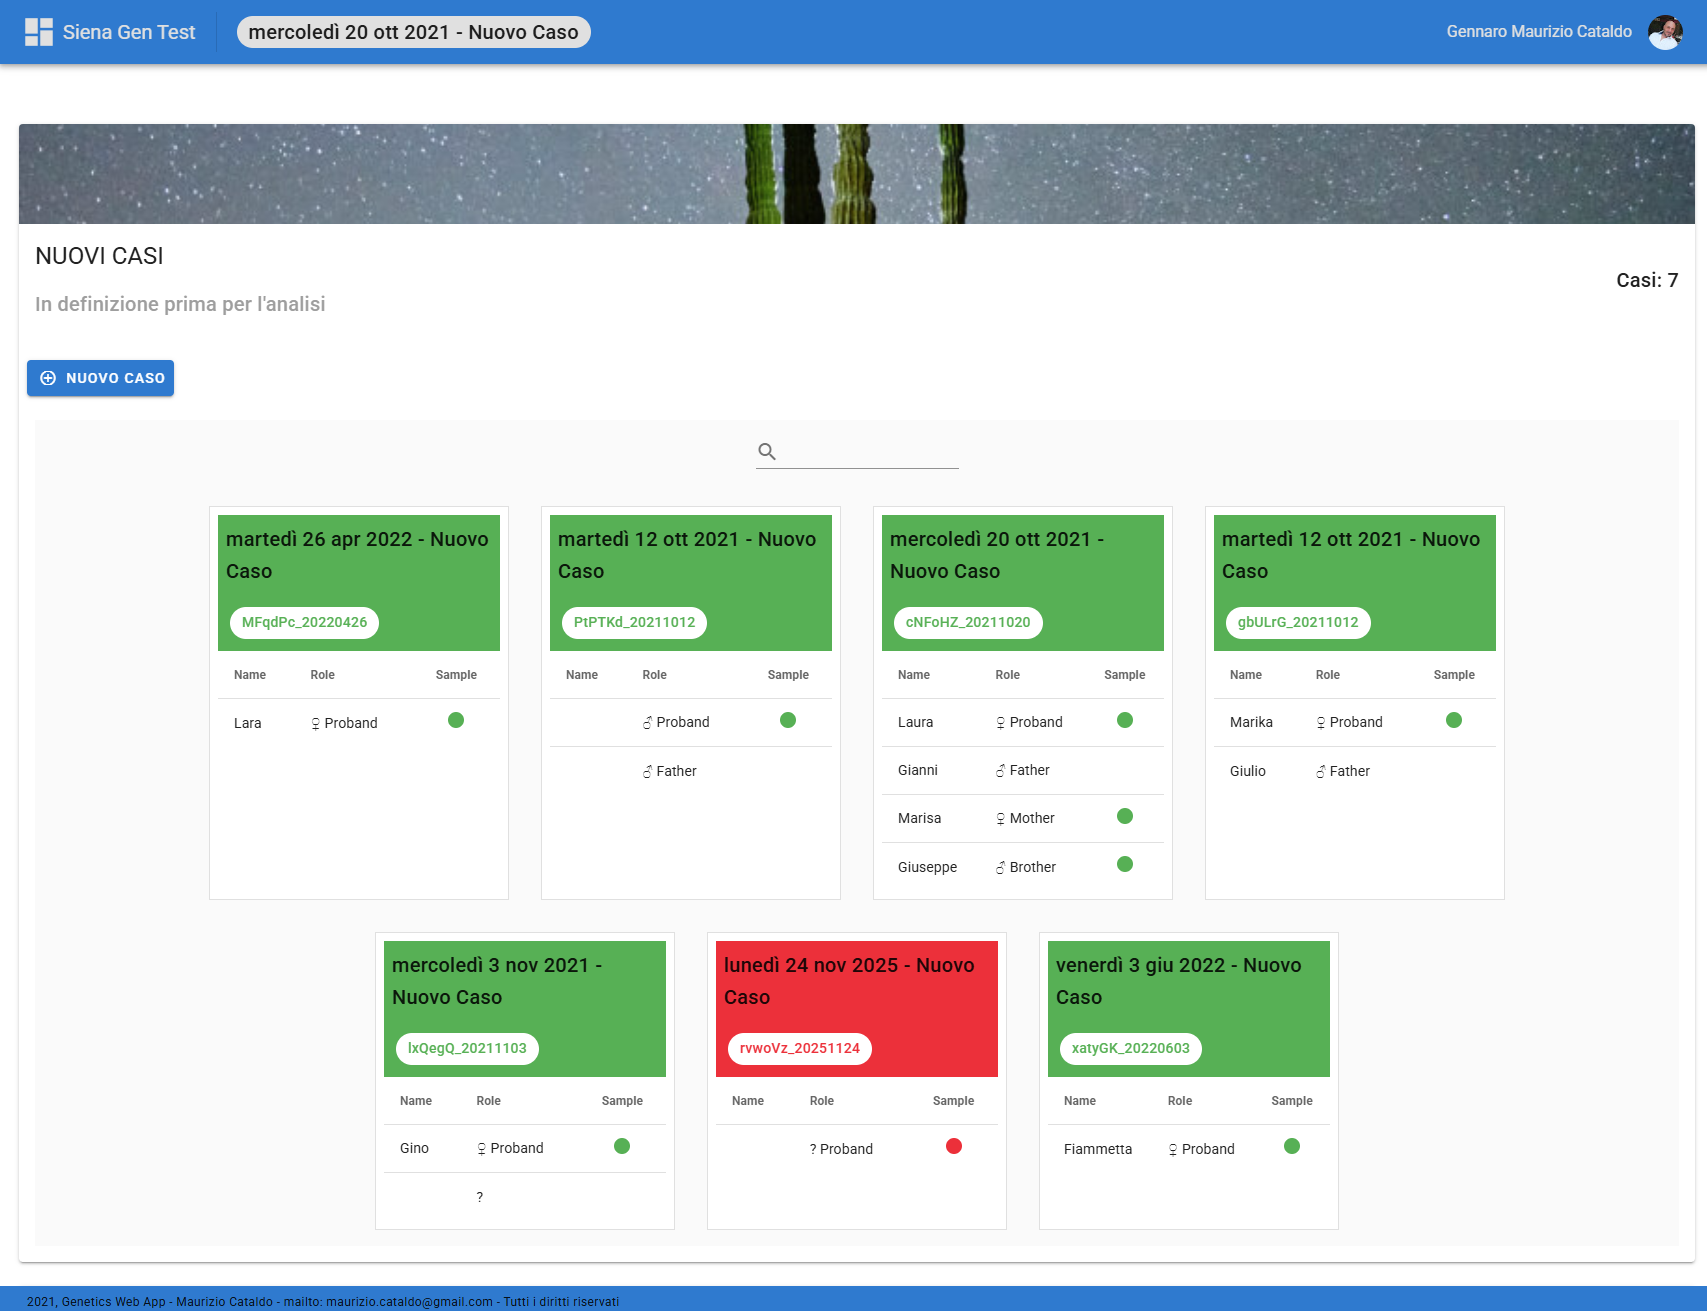
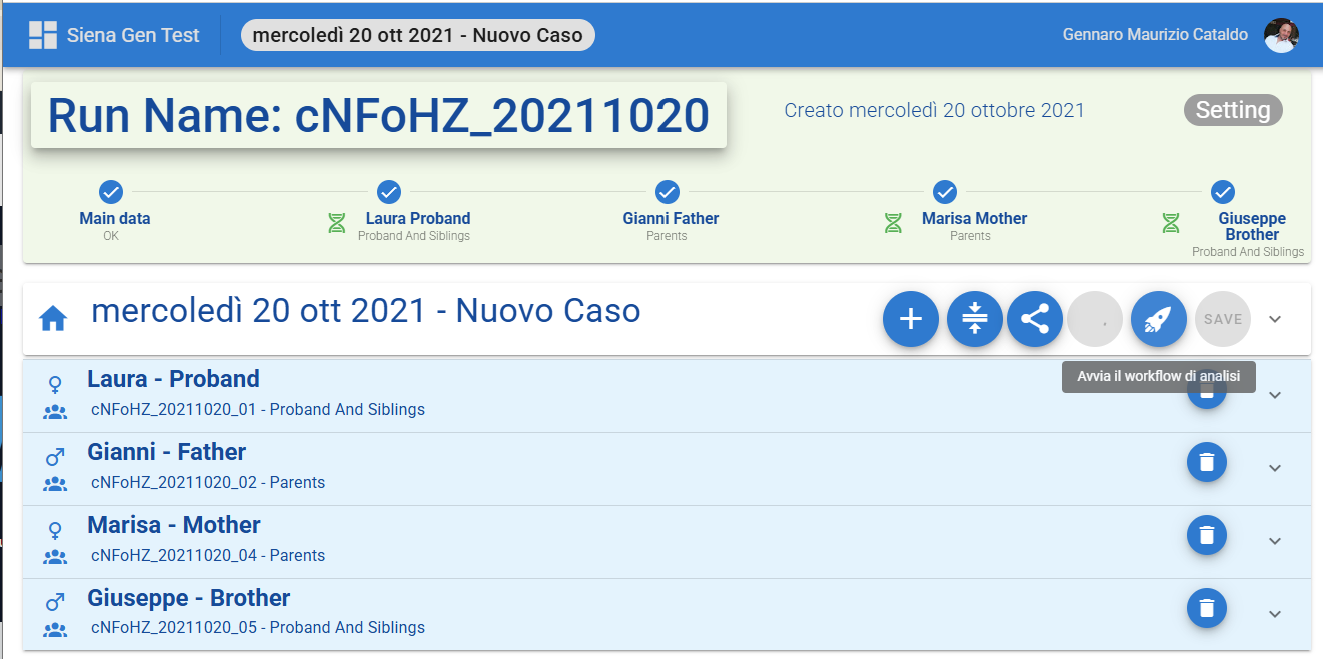
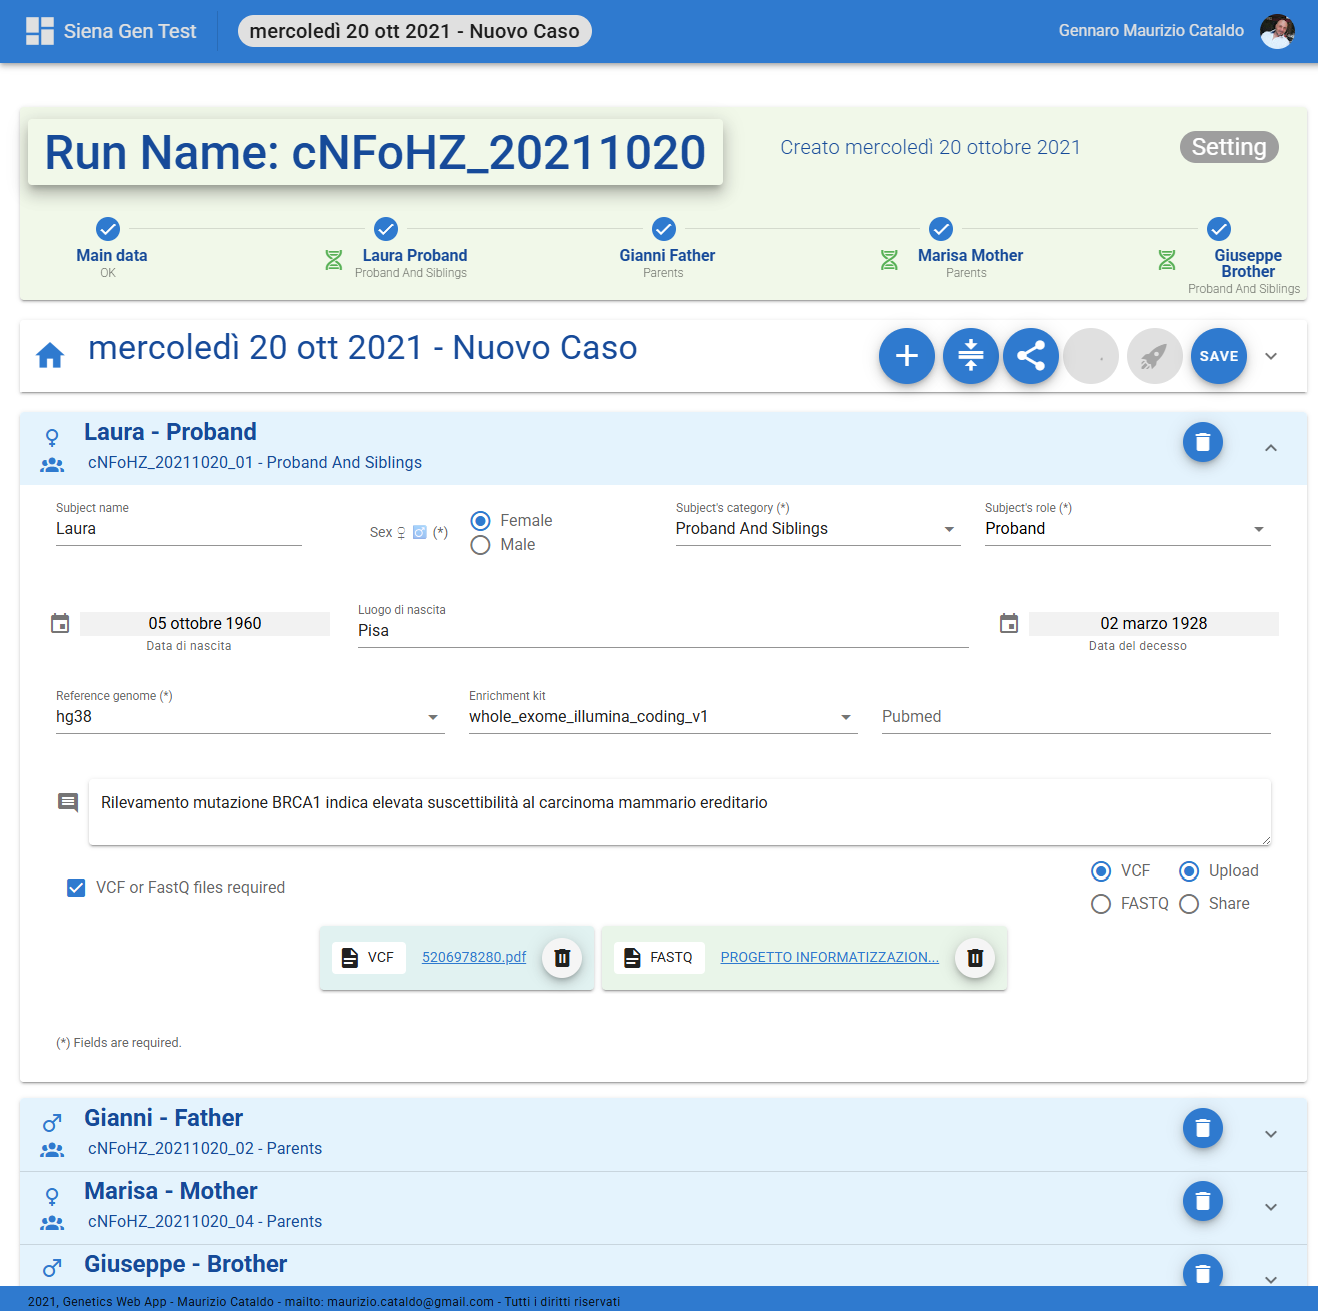
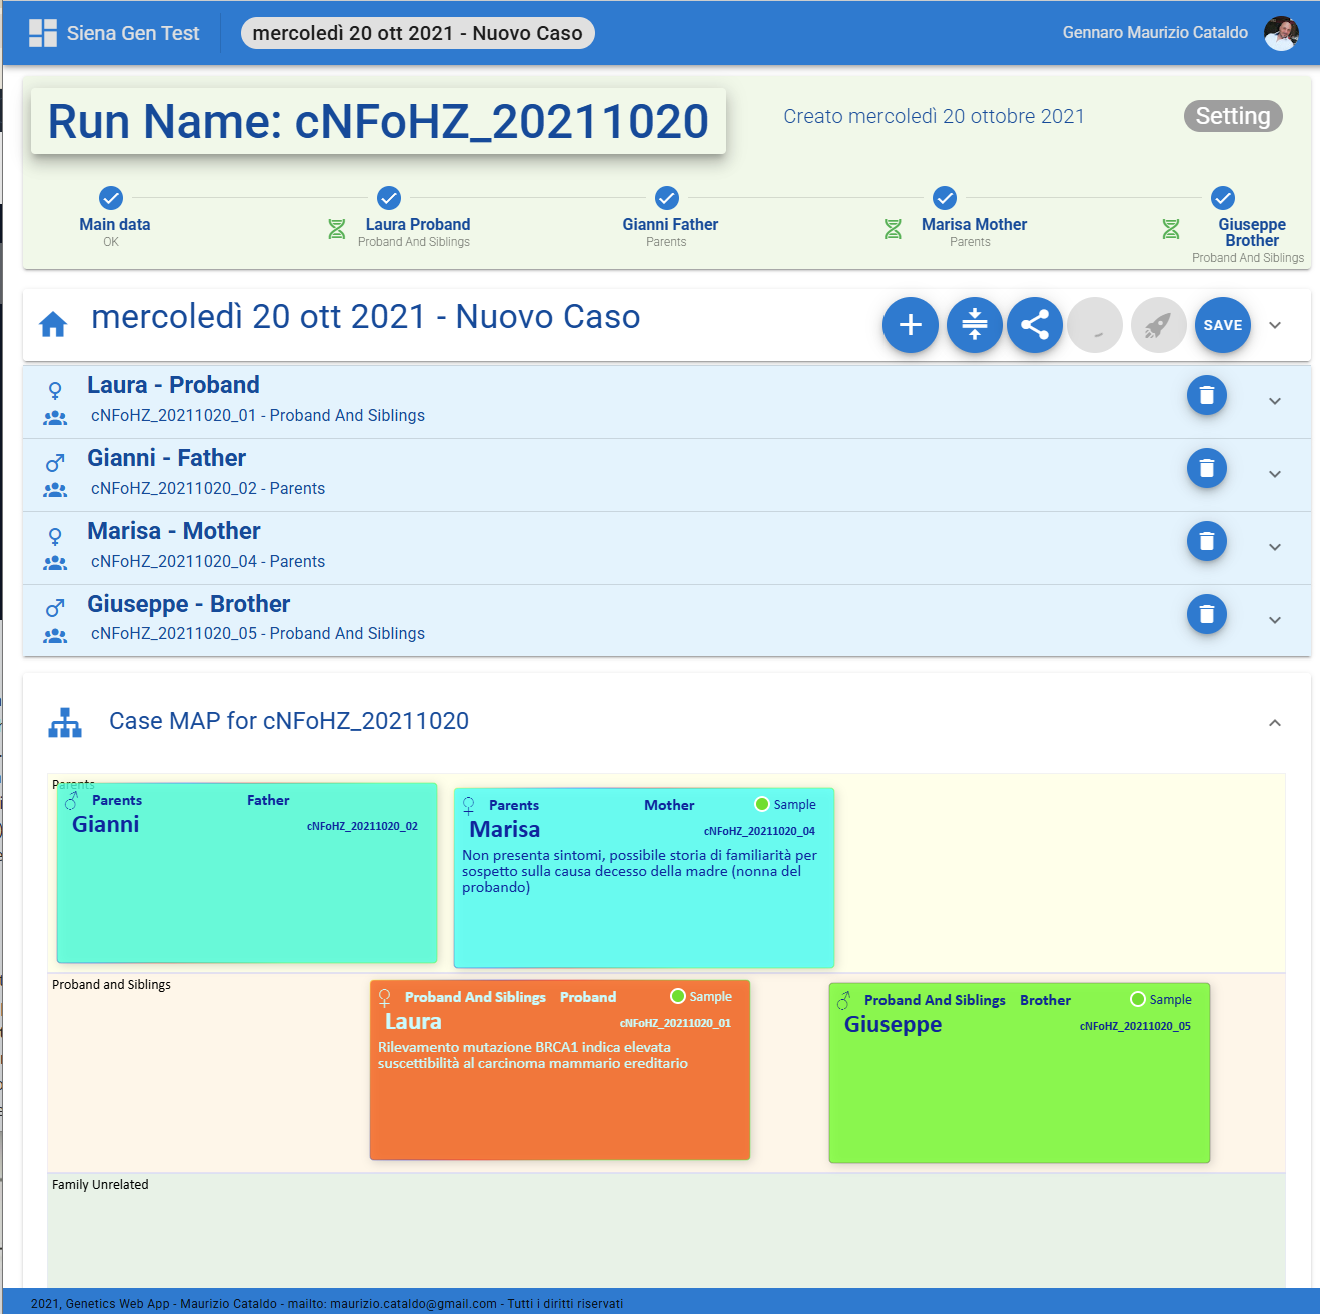
Fig 2. WebApp Screenshots
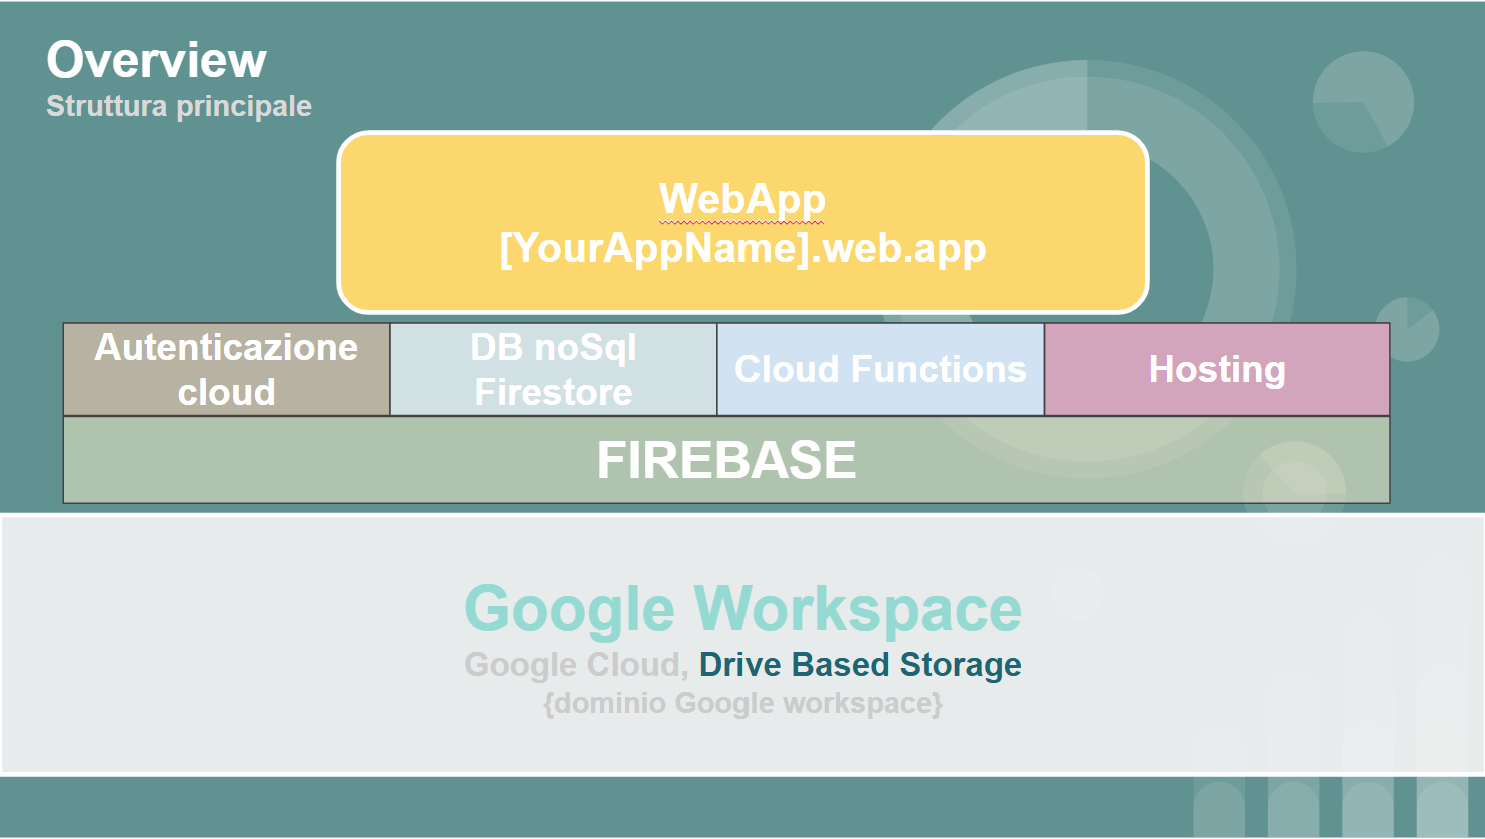
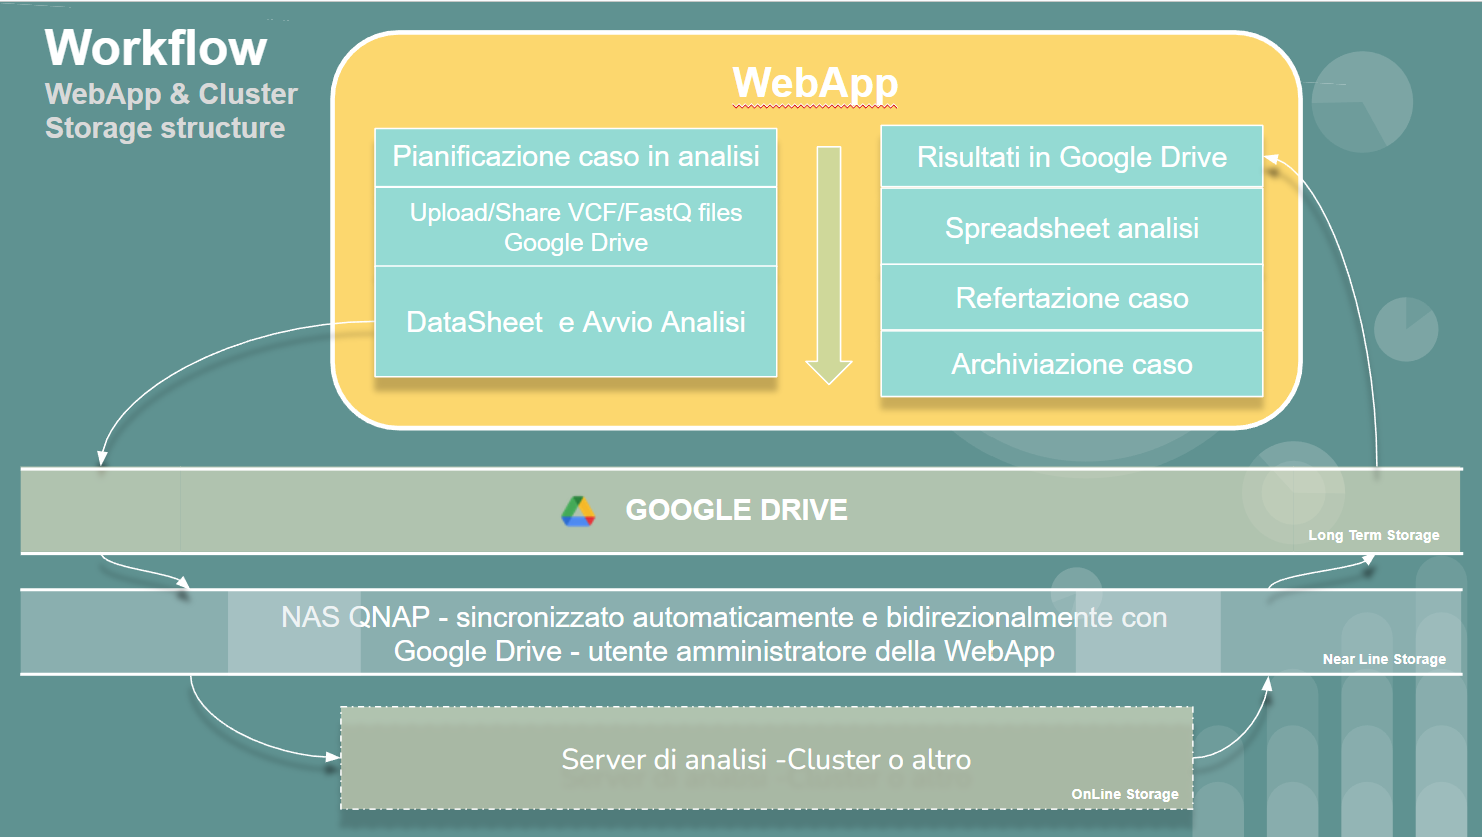
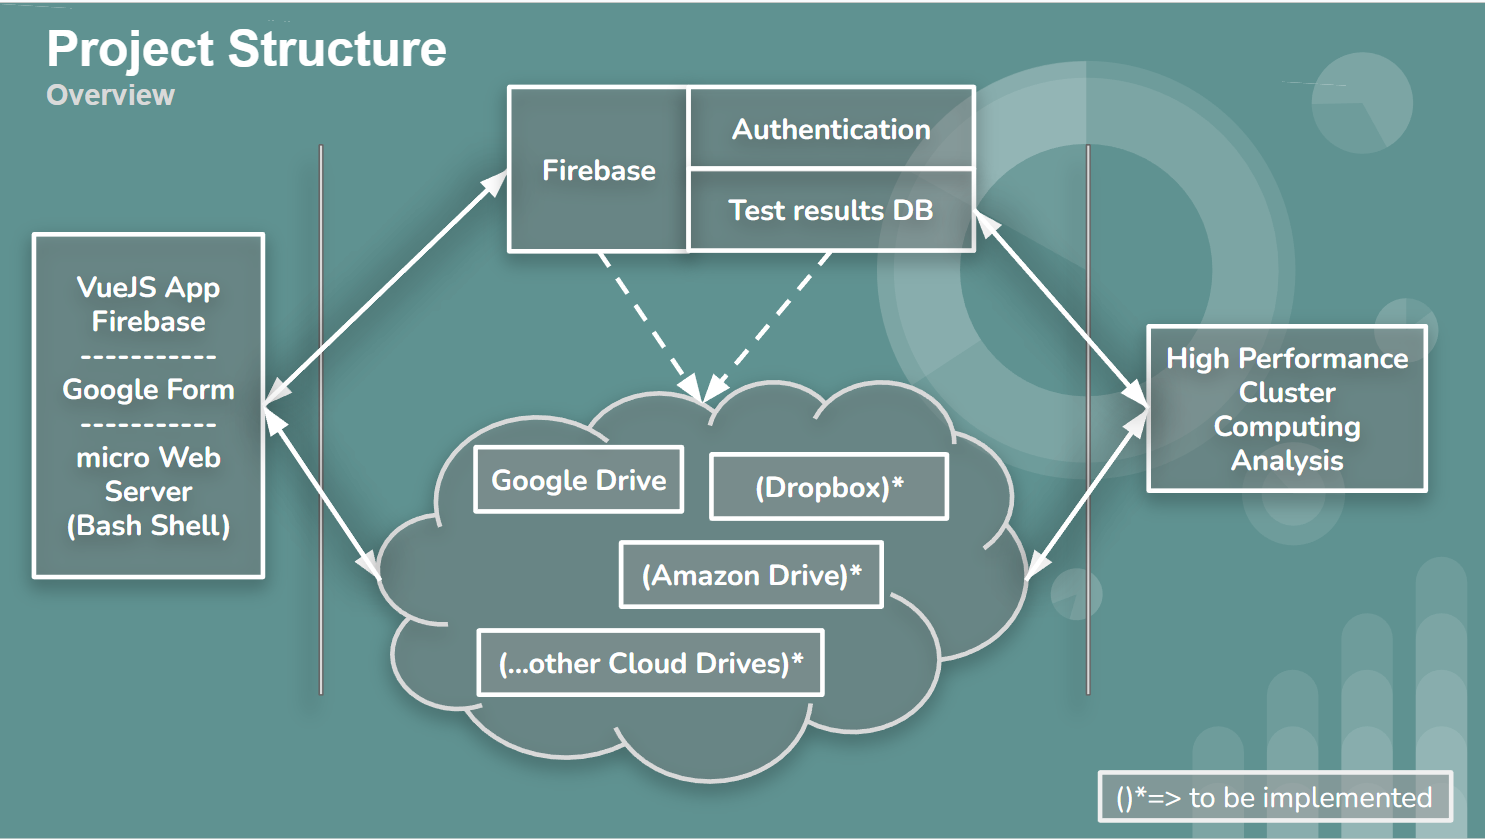
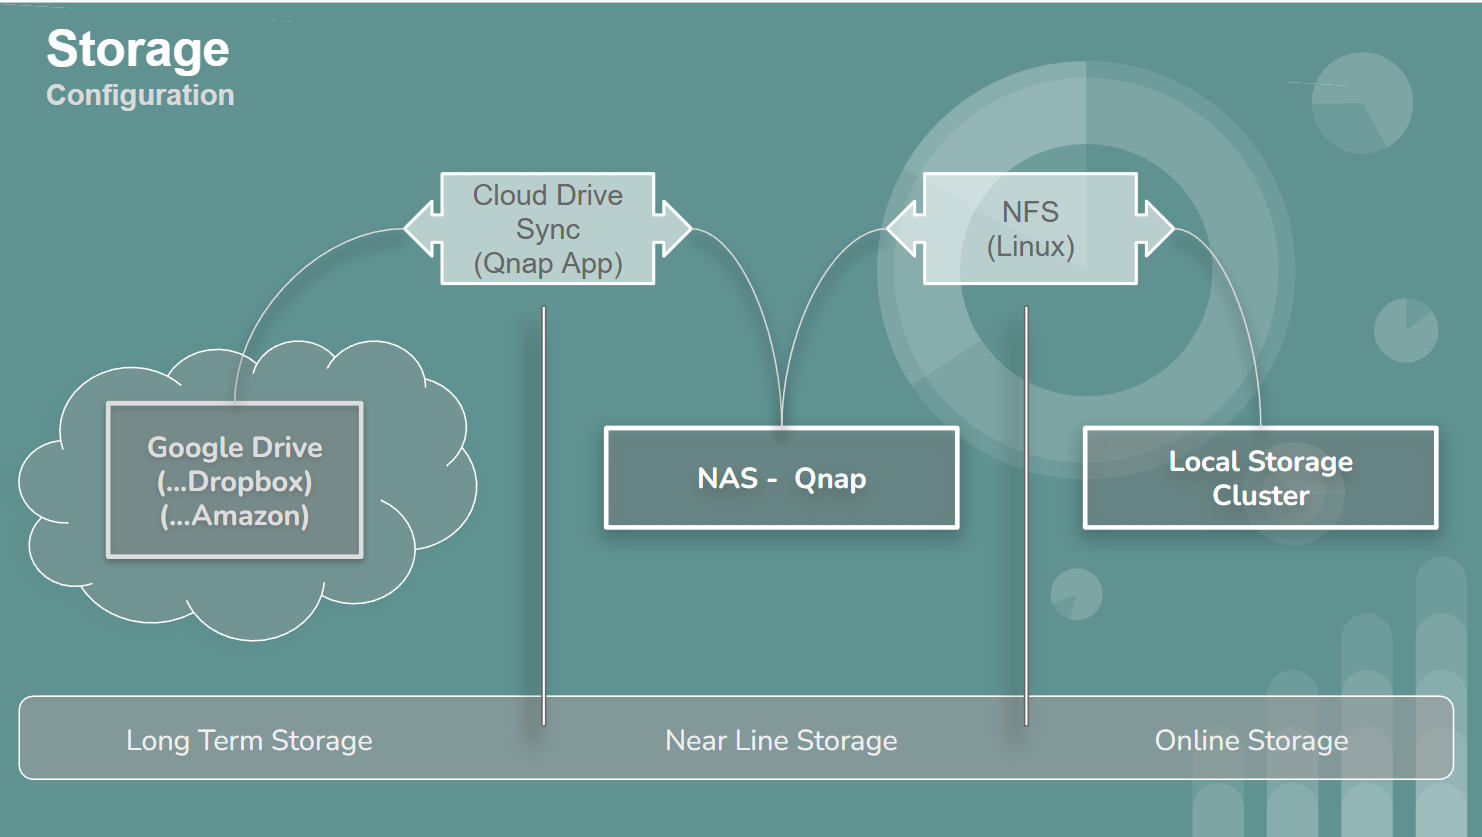
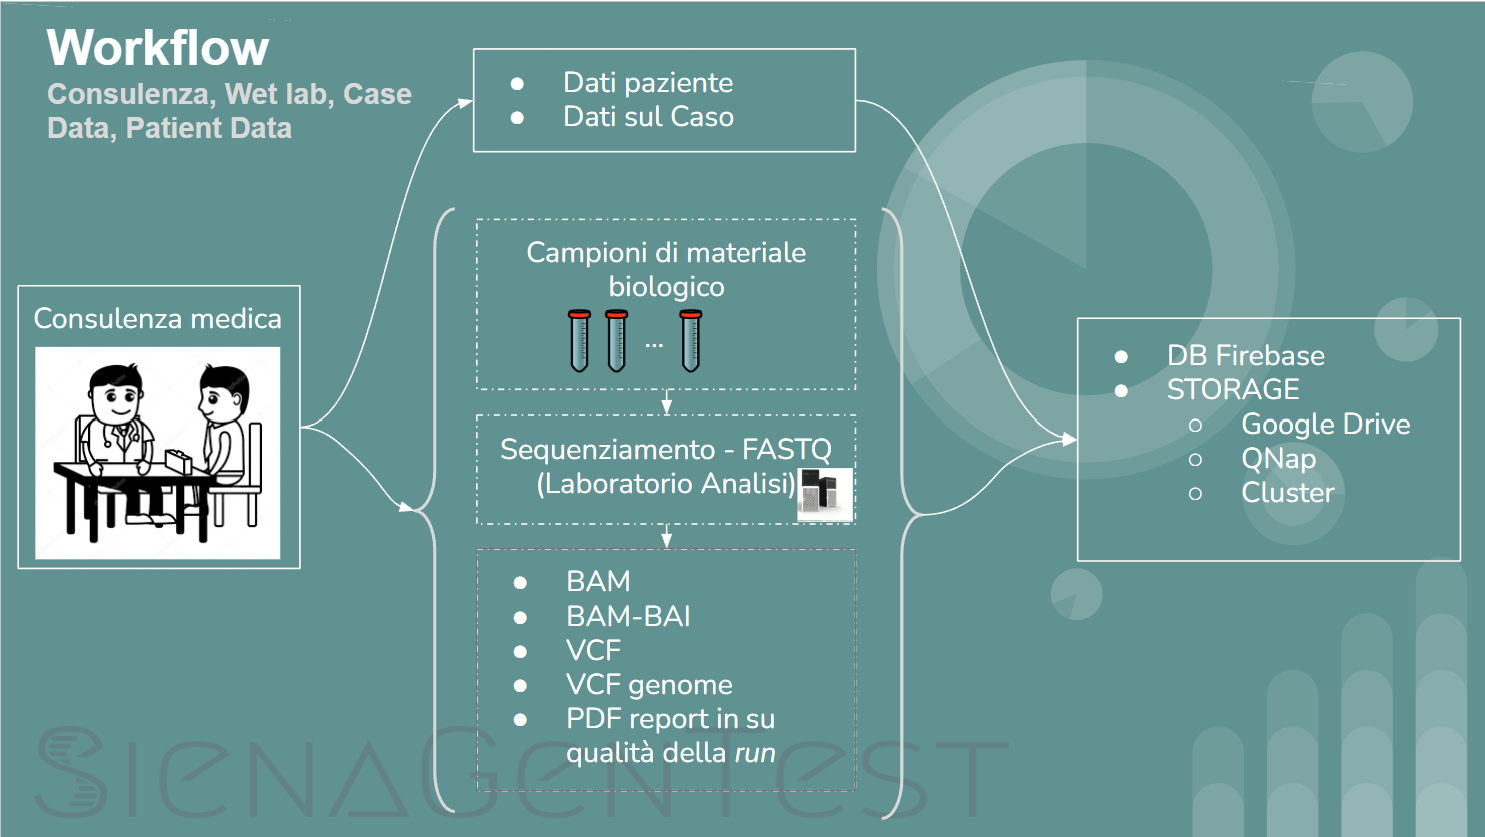
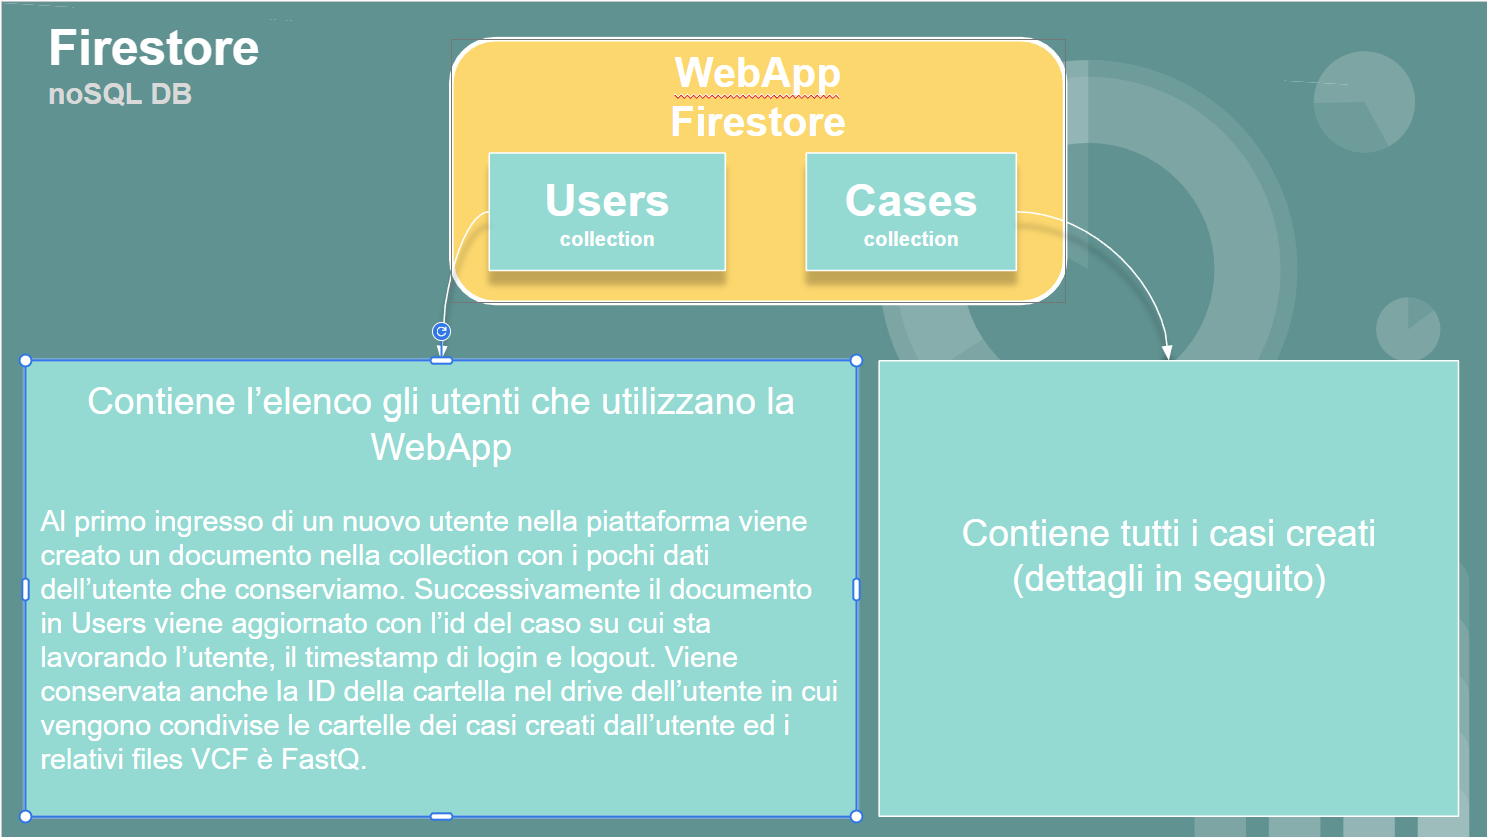
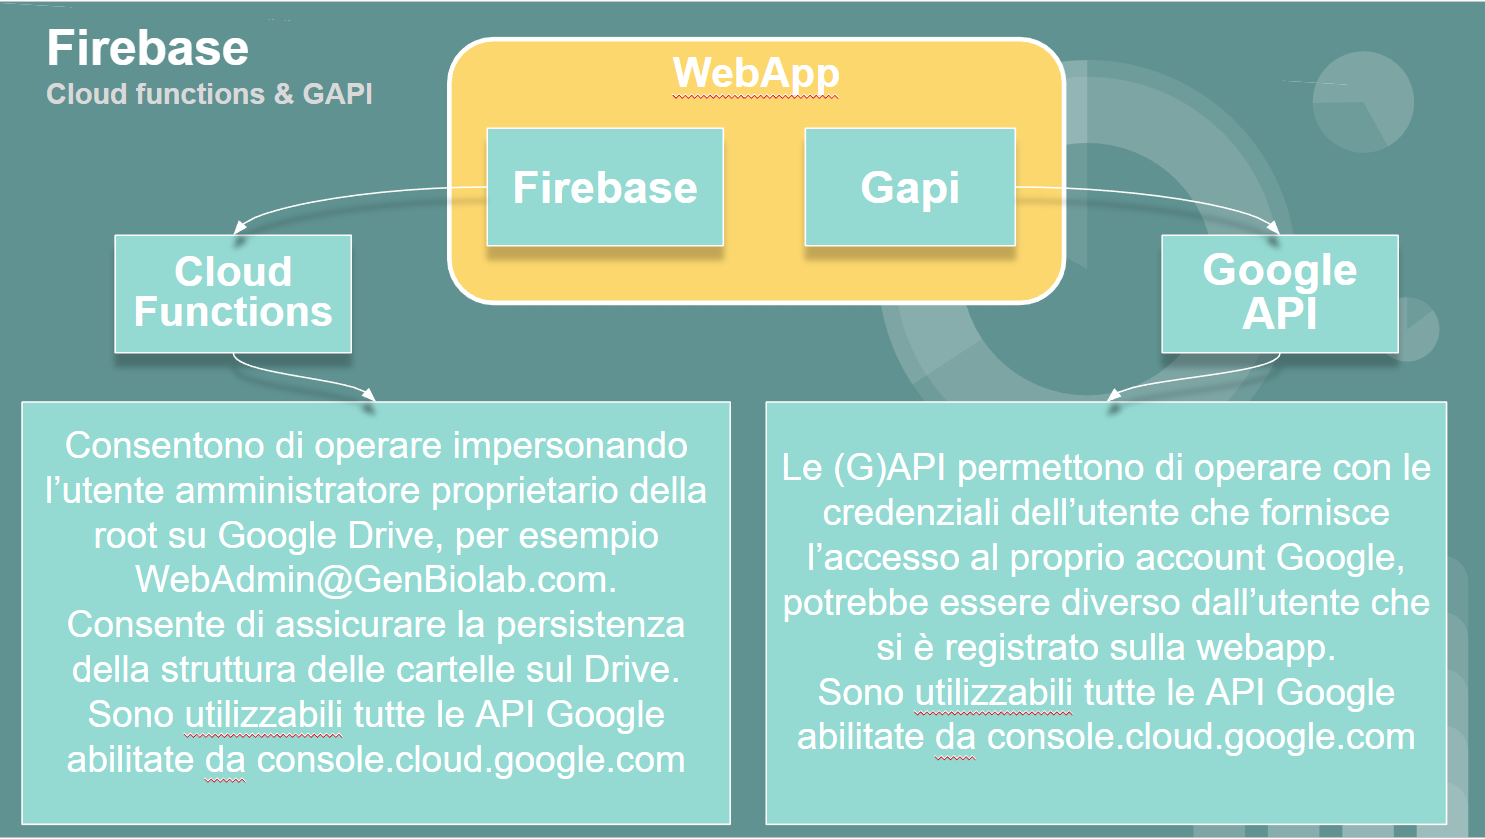
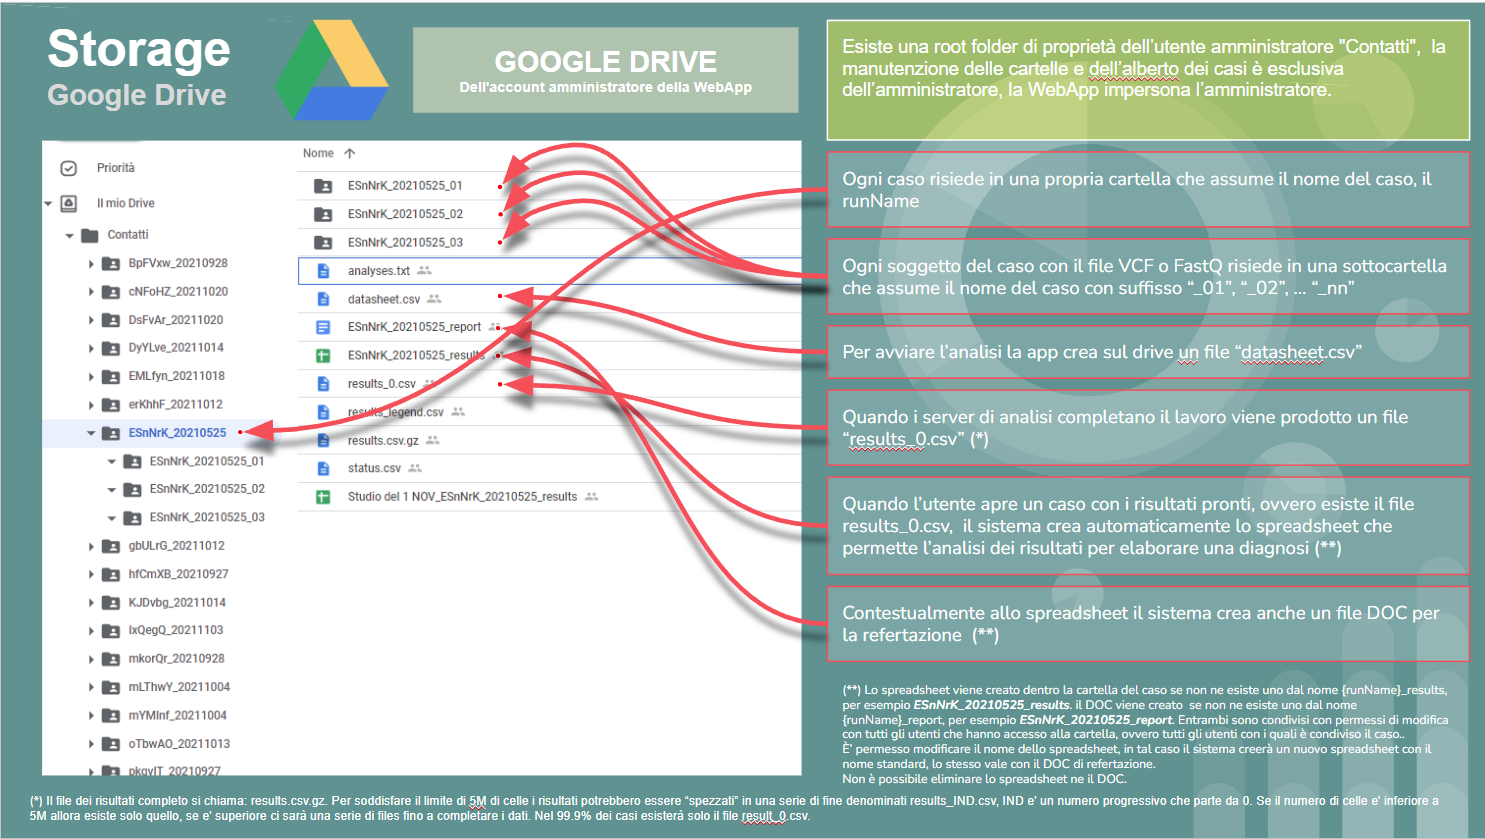
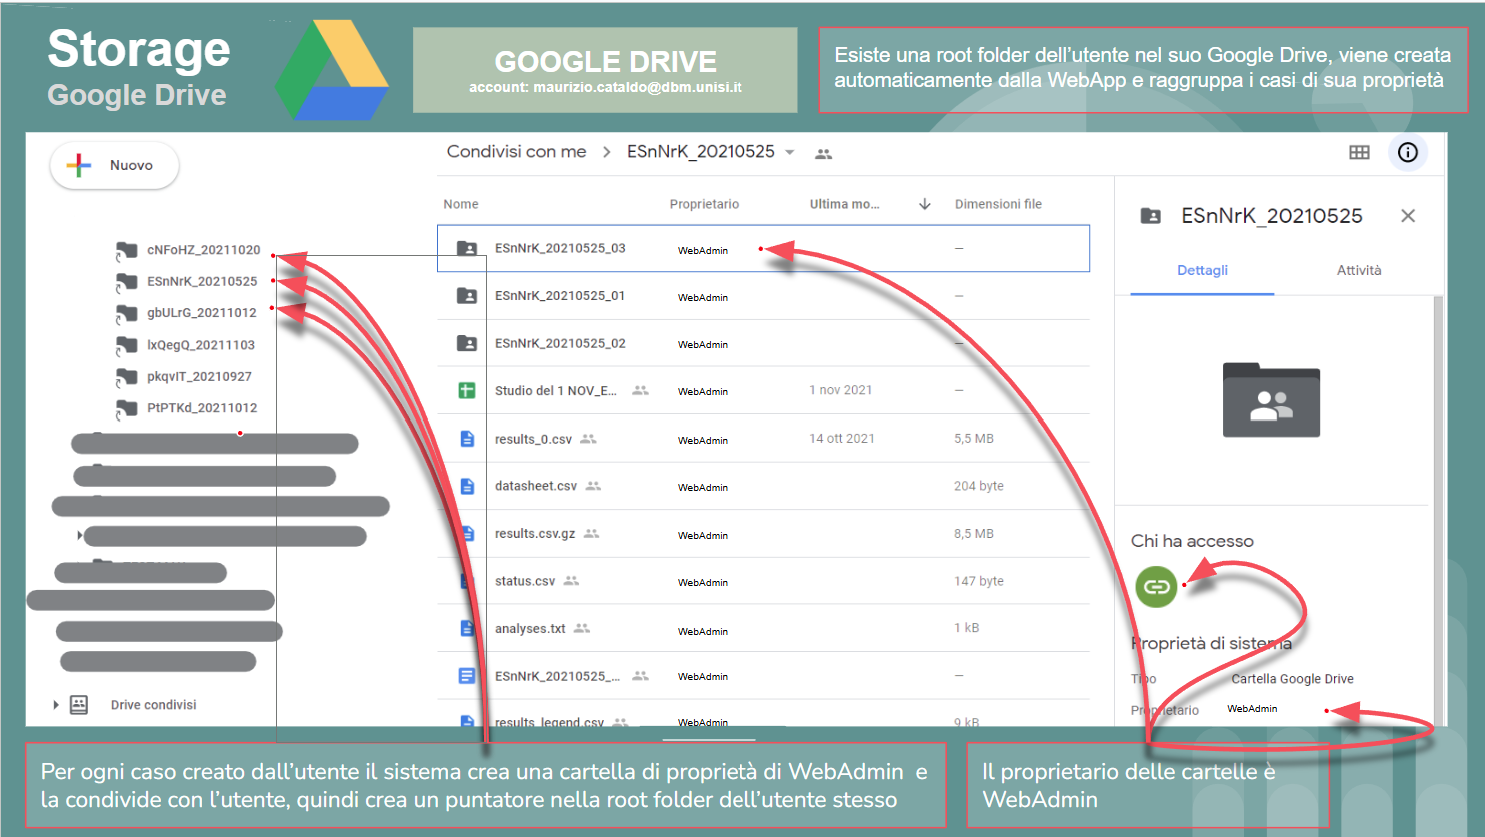
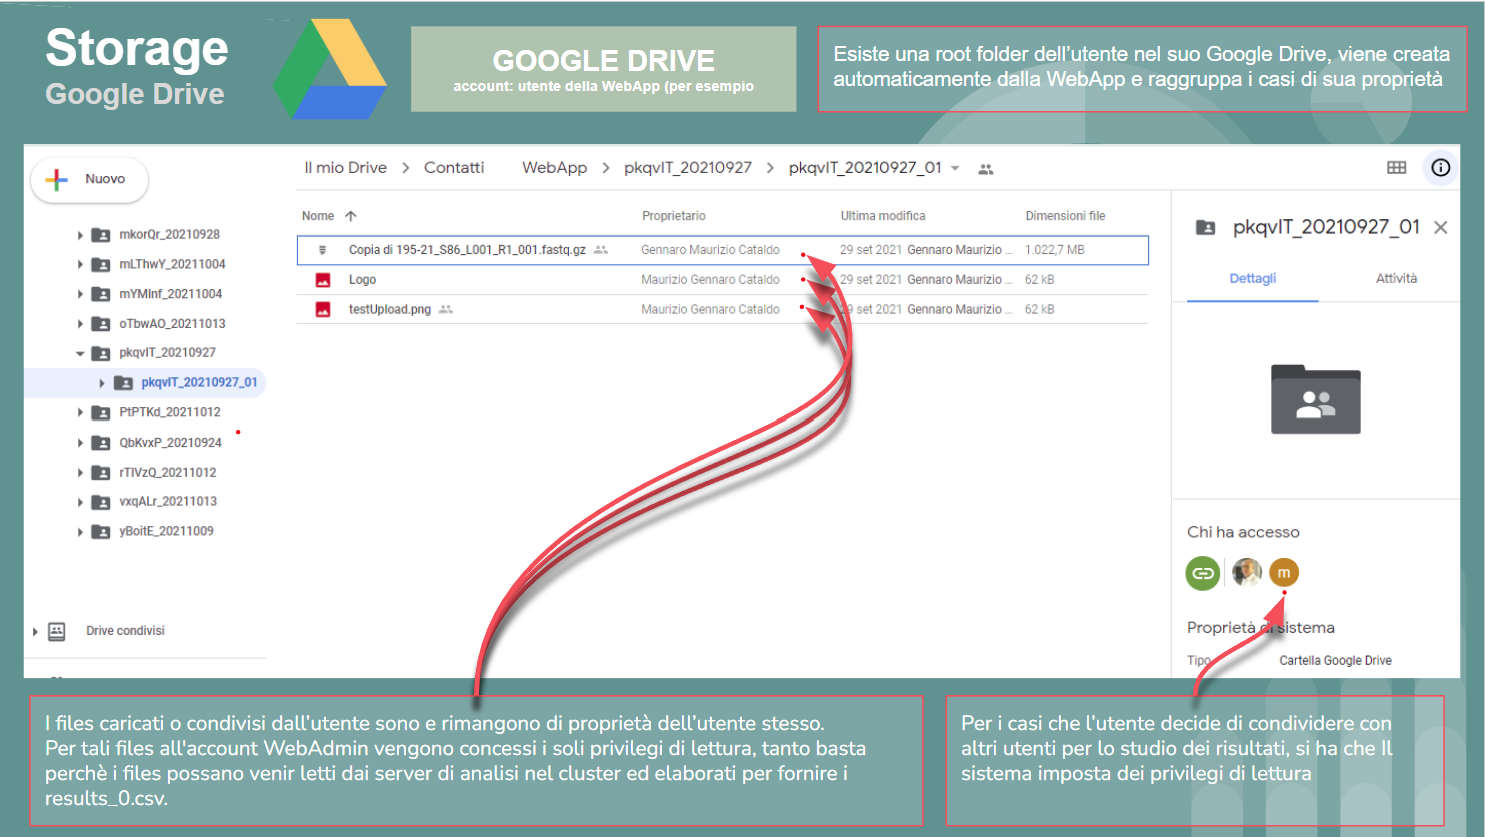
Fig 3. Genomic Pipeline Orchestrator Project Structure
Ti interessa una soluzione simile?
Parliamo di come applicare un'architettura simile al genomic pipeline al tuo scenario specifico
Se preferisci compila il form ed entriamo in contatto, organizzeremo una chiamata telefonica e ti manderò della documentazione PDF
Prossimo Case Study